Assignment 1
과제를 하면서 새롭게 알아간 내용을 정리해보자.
아무리 공부해봤자 Gemini3보단 코딩을 못하겠지만 최선은 다해봐야지..
개인적으로 재밌었던 과제였다.
1번에 속한 문제들은 동작 원리를 파이썬으로 구현하는 문제들,
2번에 속한 문제들은 워드 임베딩에 대한 감각을 깨우치는 문제들이었던 것 같다.
1. List Comprehension Way
막 엄청 새로운 건 아니지만 코드가 깔끔해보이고 싶다면 알아두면 좋다.
파이썬에서 리스트를 간결하고 직관적으로 만들기 위한 문법인데, 과제에서 List를 Flatten하기 위해 사용한다.
얼마나 깔끔해지는지 Loop Way와 비교해보자
# Loop Way

list_of_lists = [range(4), range(7)]
flattened_list = []

#flatten the list

for x in list_of_lists:
    for y in x:
        flattened_list.append(y)
# List Comprehension Way
#The list of lists
list_of_lists = [range(4), range(7)]
#flatten the lists
flattened_list = [y for x in list_of_lists for y in x]꽤 깔끔해진다.
2. Assert
스탠포드는 과제마저 다른 것인가
너무 정리가 잘 되어 있다.
assert 라는 디버깅용 도구를 사용해서 내가 짠 코드가 잘 작동했는지 테스트를 넣어놓는다.
단순화된 사용 예시를 정리해놓자.
# Test correct number of words
assert(answer == my_answer), "Error message : Correct : {}, yours : {}".format(10, my_answer)
print("u r correct!")

# 만약 오답 : "Error message : Correct : 10, yours : 80" 출력 후 프로그램 중단
# 만약 정답 : "u r correct"
3. PCA 결과의 원점 대칭
1.5번 문제를 보면, 과제 파일에 있는 워드 임베딩의 차원축소 플롯과 내 플롯이 원점을 기준으로 반전이 되었다.
이전에 학교에서 과제를 하다가 같은 코드에, 같은 시드를 설정하고 코드를 실행해도 이렇게 원점 기준 반전이 되는 경우가 있었던 기억이 있는데, 그 이유가 궁금해져 찾아보게 되었다.
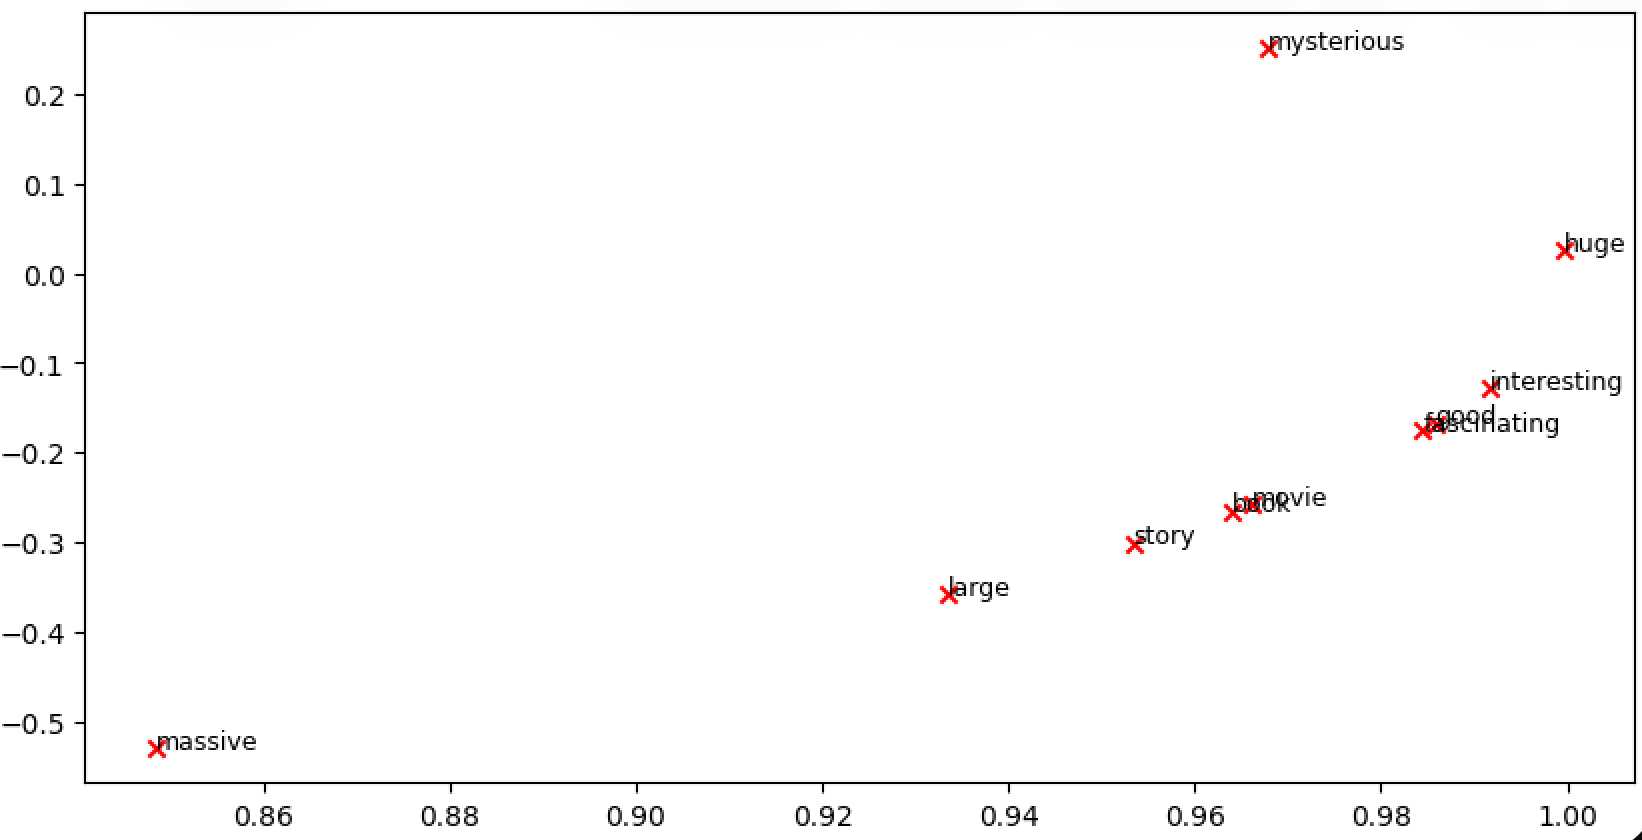
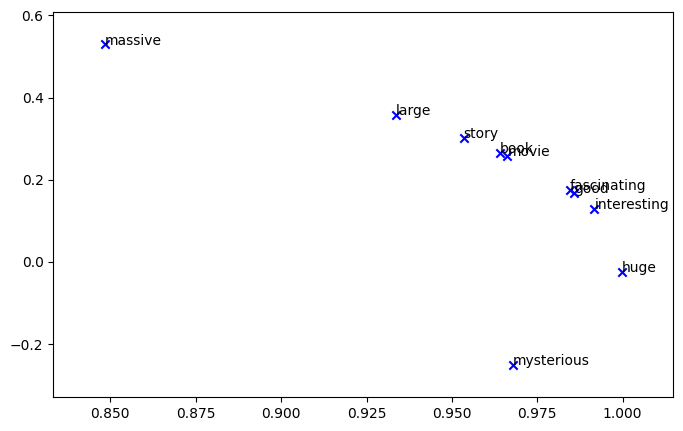
- 문제 제기 : 차원축소(PCA) 결과를 시각화할 때, random_space를 고정했음에도 불구하고, 그래프가 원점 기준 반전됨
- 수학적 원인 : Eigenvector Sign Indeterminacy
-> PCA의 주성분(Principal Component)은 공분산 행렬의 고유벡터이다. (2학년 행렬시간에 배웠던 기억이) $v$가 고유벡터라면 $-v$ 역시 유효한 고유벡터이므로 수학적으로 축의 방향은 유일하게 결정되지 않는다. 즉, 왼쪽과 오른쪽은 같은 정보를 포함하고 있는 플롯이라는 것이다. 두 고유벡터의 음/양 방향이 모두 반전되었으니까 원점을 기준으로 반전된 그래프처럼 보이는 것이다. 의미가 같다는 것은 알겠고, 그럼 왜 뒤집히는걸까?
random.seed()를 과제 원본과 같은 값으로 설정하면 그래프가 똑같이 나올까 했는데, Scikit-learn의 PCA는 난수를 쓰지 않는 결정론적 알고리즘이라고 한다. 따라서 시드 설정은 중요하지 않고, 실행 환경(mac, 코랩, 리눅스)의 차이에 의해서 또는 scikit-learn 내부 넘파이 등의 버전 차이에 의해 부호가 뒤집할 수 있다고 한다. 사소한 궁금증 해결.
4. 코사인 거리 = 1 - 코사인 유사도
라는 사실